┌─────────────────────────────┐
🛒 Amazonで最新ガジェットをチェック
PC・タブレット・ゲーミングデバイス・周辺機器を探す
└─────────────────────────────┘
ローカルLLMというと、
「高性能なゲーミングPCが必要なのでは?」
「GPUがない会社PCでは動かない?」
「ChatGPTの代わりになるAIを、自分のPCだけで動かせる?」
と気になる人も多いと思います。
そこでAI Motion Labでは今回、
Intel Core i5-1235U
RAM 8GB
Intel Iris Xe Graphics
という、かなり普通の業務用Windows PCにLM Studioを入れて、実際にローカルLLMを動かしてみました。
しかも今回は、
「起動しました」
だけでは終わりません。
実際に会社員が使いそうな、
ビジネスメールの文章修正
まで試し、ChatGPTにもほぼ同じプロンプトを入力して結果を比較しました。
先に結論です。
RAM 8GBでもローカルLLMは動きました。
ただし、「動く」と「仕事で快適に使える」は別でした。
最初に試したQwen3 4Bでは、メモリ使用率が約92%。
そこでさらに軽い、
Qwen3 1.7B / Q4_K_M
までモデルを小さくしました。
モデルファイルは1.28GB。
これなら8GB PCでも余裕が出ると思ったのですが、
広告

そして肝心のメール修正では、
ChatGPTの方が明らかに自然で、そのまま使いやすい文章
になりました。
今回の検証で一番よく分かったのは、
「ローカルLLMを起動できるPC」と「ローカルLLMを仕事で快適に使えるPC」は違う。
ということです。
今回使用したPCはこちらです。
| 項目 | 実機スペック |
|---|---|
| CPU | Intel Core i5-1235U |
| RAM | 8GB |
| メモリ速度 | 3200MT/s |
| GPU | Intel Iris Xe Graphics |
| ストレージ | 約477GB |
| 主な用途 | Office・メール・Webなど |
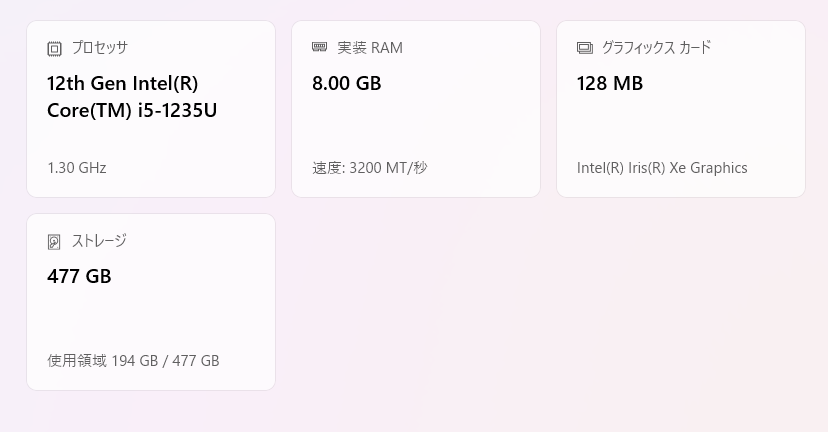
今回使用したWindows PC。Core i5-1235U、RAM 8GB、Intel Iris Xe Graphicsという一般的な業務PCに近い構成。
いわゆる、
AI用に用意したPCではありません。
Word。
Excel。
ブラウザ。
メール。
Web会議。
といった仕事で使われるPCに近い構成です。
だからこそ、
「普通の会社PCでも本当にローカルLLMは使える?」
を確認するには面白い環境です。
普段ChatGPTを利用する場合は、
PC → インターネット → クラウド上のAI
という形で処理されます。
一方、ローカルLLMでは、
PC → PC内部に保存したAIモデル → 回答
という構成になります。
つまりAIモデルそのものをPCへ保存し、
CPUやGPU、RAMを使って回答を生成します。
そのため、
自分のPC性能が、そのまま使えるAIモデルの制約になります。
ここがChatGPTとの大きな違いです。
今回ローカルLLMを動かすために使用したのが、
LM Studio
です。
2026年現在、公式サイトを開くと、
LM Studio Bionic
と、
LM Studio
の両方が表示されています。
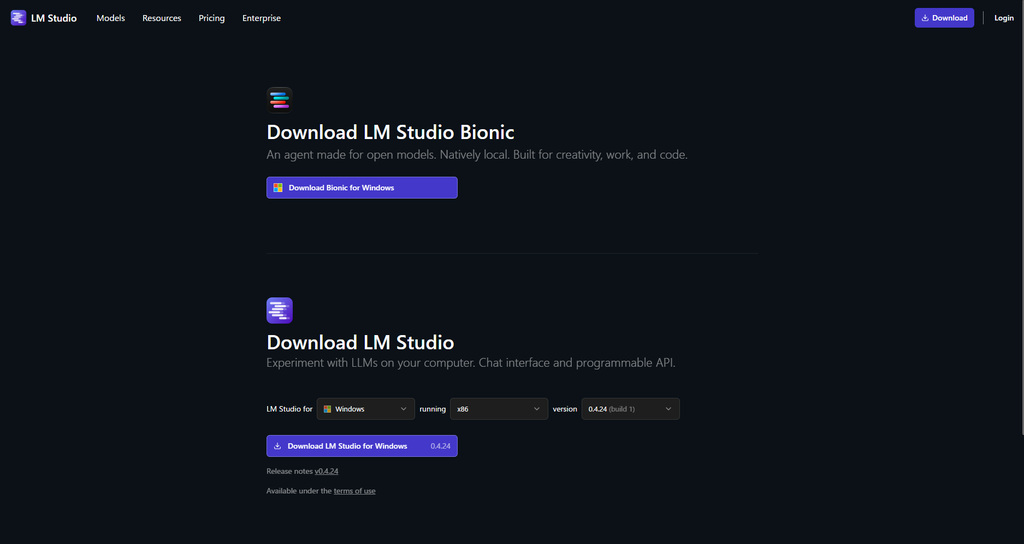
Bionicは、オープンモデルをAIエージェントとして使うための新しいアプリです。
一方、従来版LM Studioは、
モデルを探す。
ダウンロードする。
量子化を選ぶ。
読み込む。
チャットする。
といった、
ローカルLLMそのものを試す用途
に向いています。
今回はPCスペックとモデルサイズの関係を確認したいので、
従来版LM Studio
を使用しました。
今回使用したのは、
LM Studio 0.4.24
です。
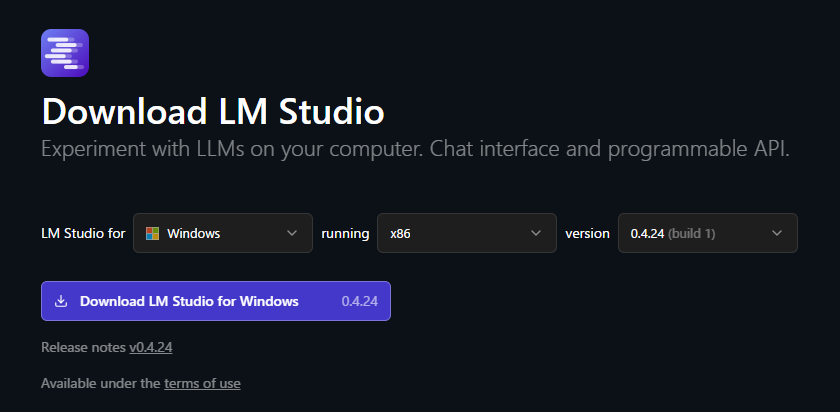
ダウンロードした、
LM-Studio-0.4.24-1-x64.exe
を起動します。
インストール作業自体は難しくありませんでした。
利用条件を確認します。
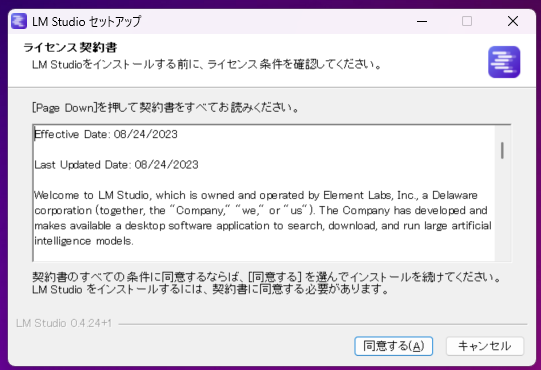
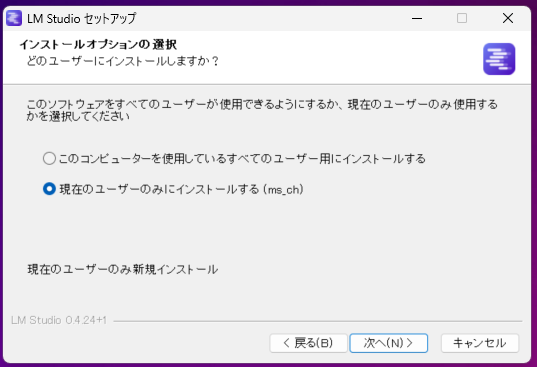
今回は現在のユーザーのみにインストール。
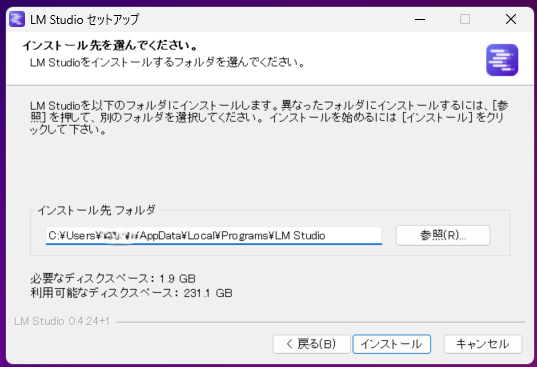
必要なディスク容量は約1.9GBと表示されました。
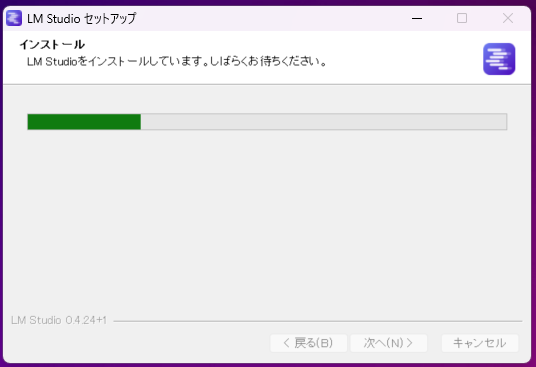
Python。
コマンド。
プログラミング。
などは使っていません。
ここまでは普通のWindowsアプリを入れる感覚です。
デスクトップにLM Studioのショートカットが作成されます。
起動すると、
Local AI on your computer.
と表示されました。
ローカルLLMという言葉だけ聞くと難しそうですが、
LM Studioそのものを導入するところまではかなり簡単
です。
問題は、
どのAIモデルを選ぶか。
ここからでした。
初回設定では、
Gemma 4 E4B
が最初のモデル候補として表示されました。
表示されているファイルサイズは、
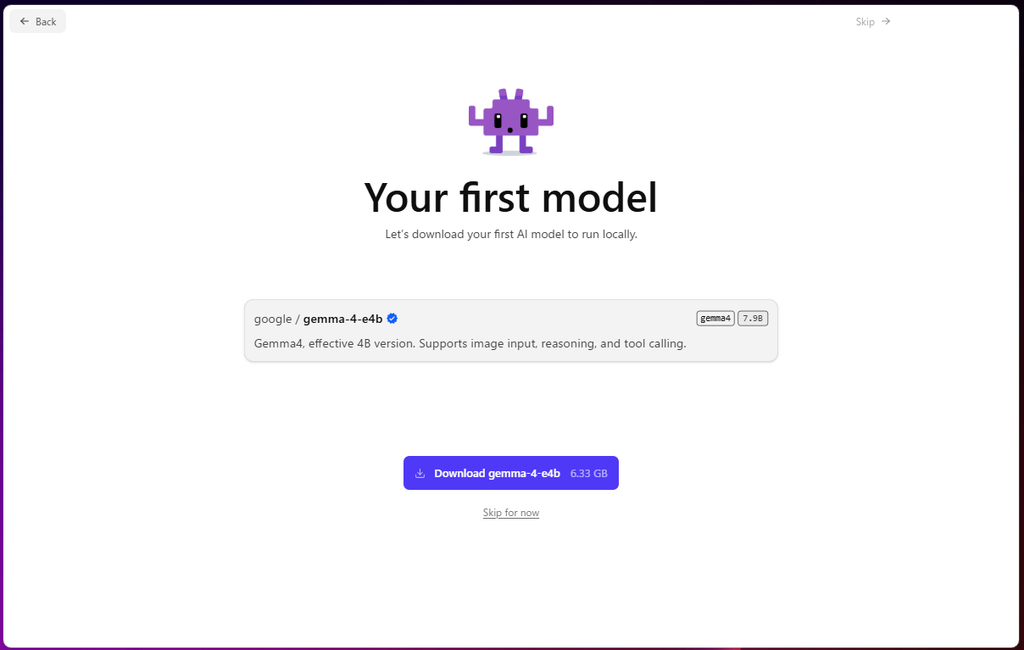
6.33GB。
今回のPCはRAM 8GBです。
さすがに、
8GB PCに6.33GBのモデルは厳しそう。
と判断しました。
そこで今回はダウンロードせず、
Skip for now
を選びます。
ここは初心者が注意したいところです。
LM Studioがおすすめしたモデル=自分のPCで快適に動くモデル
とは限りません。
特に8GB環境では、自分でモデルサイズを確認した方がよさそうです。
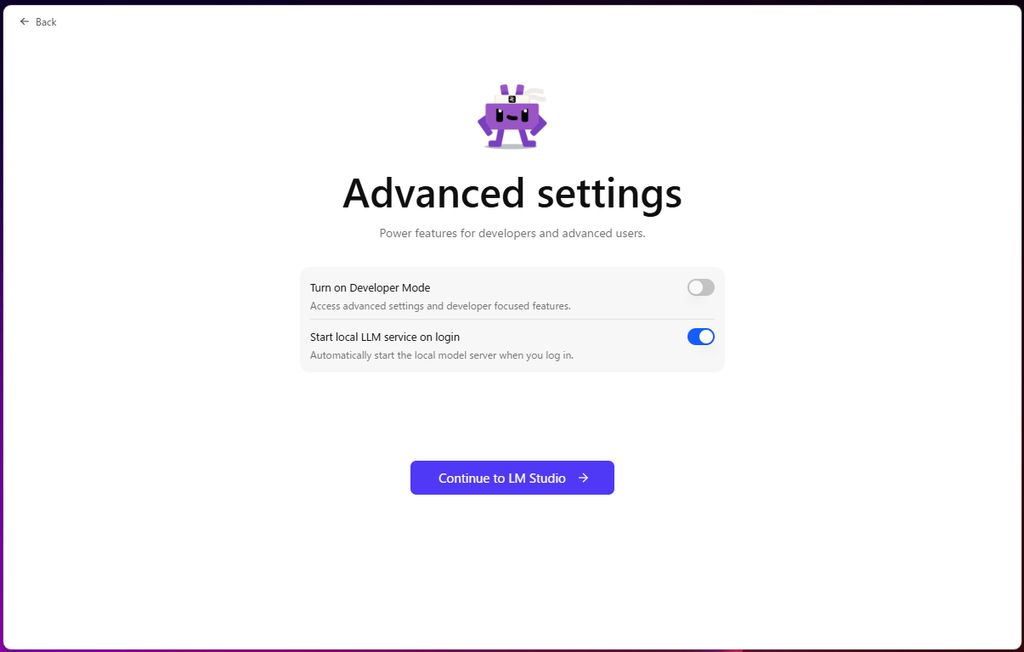
Developer Modeなどもありますが、
今回は単純に、
ローカルLLMでチャットする
ことが目的です。
余計な機能はOFFにして進めました。
ここまで来れば、
あとはAIモデルを入れるだけです。
最初に選んだのが、
Qwen3 4B Instruct
です。
最初はモデル名でうまく検索できませんでした。
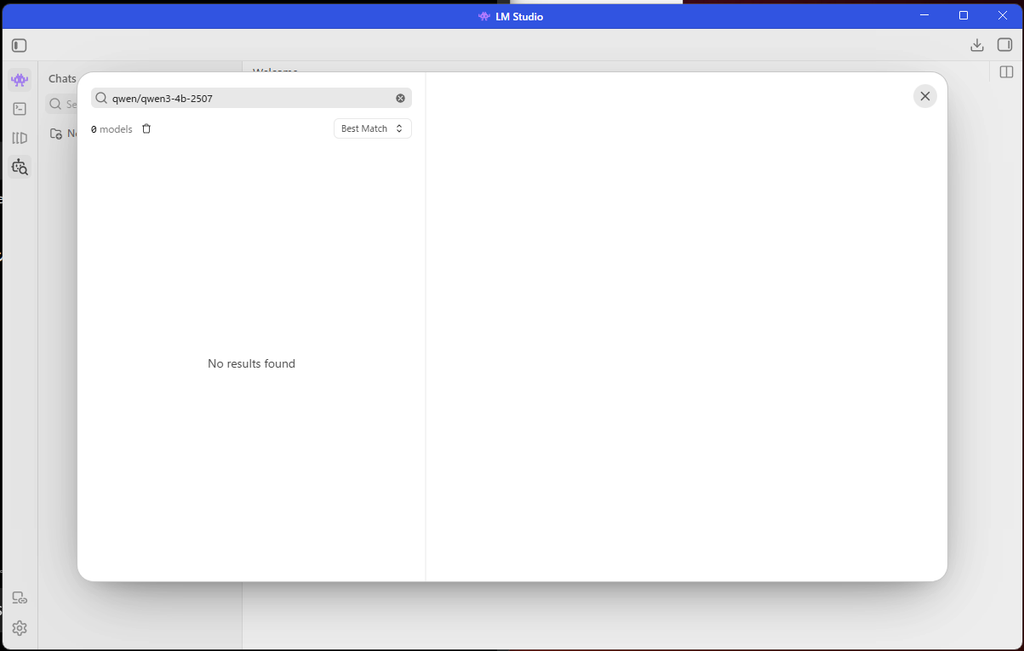
検索名を変更し、
lmstudio-community/Qwen3-4B-Instruct-2507-GGUF
を探します。
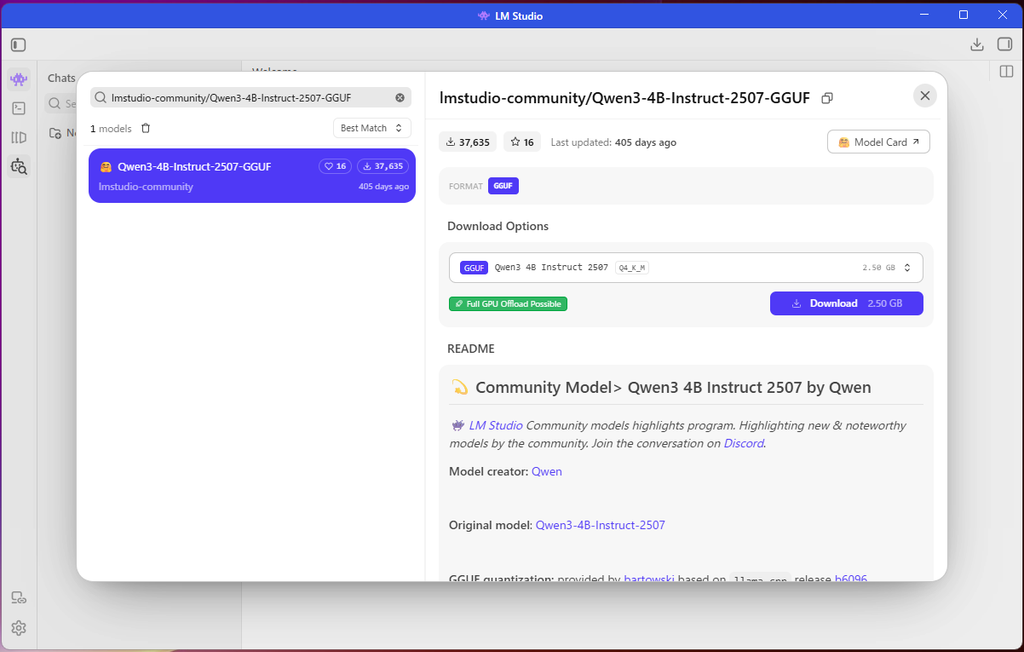
見つかりました。
今回選んだのは、
Q4_K_M
ファイルサイズ、
2.50GB。
です。
ローカルLLMでは、
Q3。
Q4。
Q6。
Q8。
などの表記をよく見ます。
これは、
量子化
の違いです。
簡単に言えば、
AIモデルを軽くして、少ないRAMやVRAMでも動かしやすくする方法
です。
8GB PCでは軽さが重要なので、
今回は、
Q4_K_M
を選択しました。
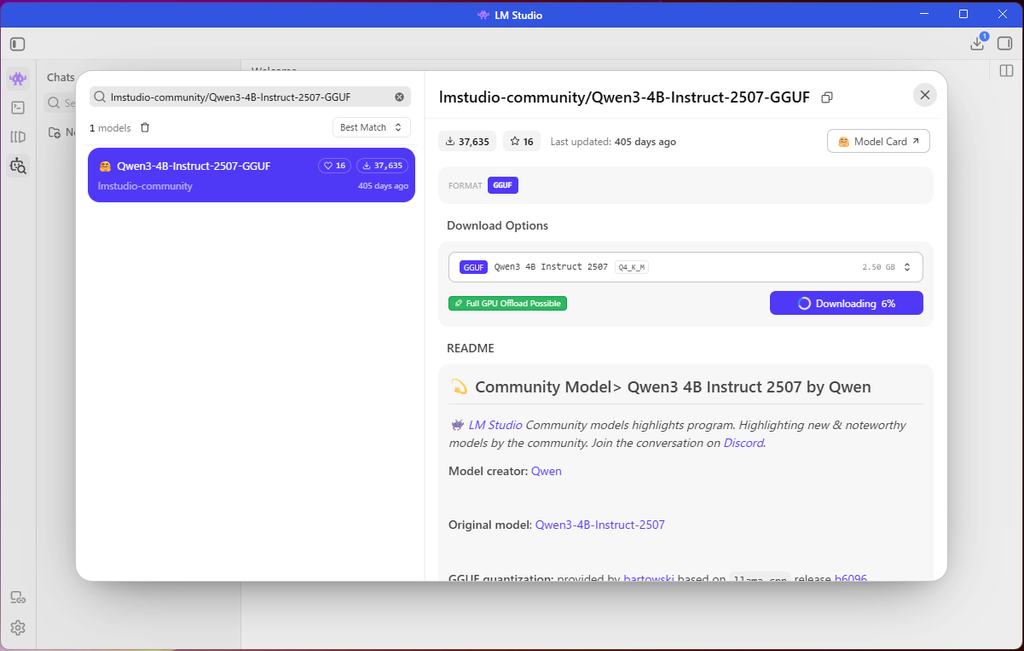
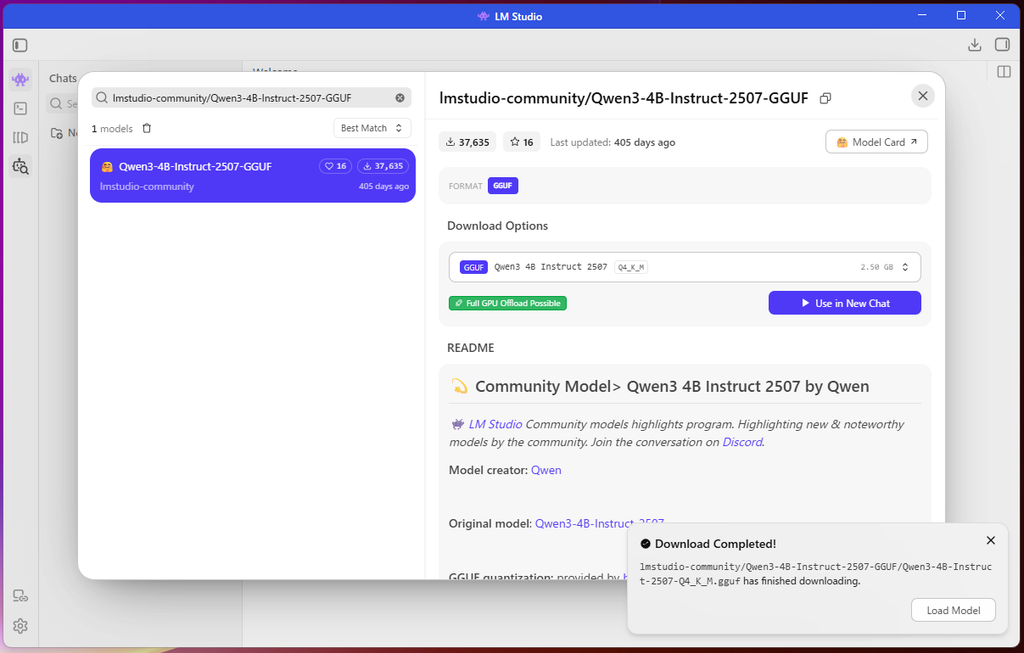
2.50GBのモデルを無事ダウンロードできました。
つまり、
8GB PCだからAIモデルをダウンロードできない
ということはありません。
問題は、
ロードして実際に動かしたとき
です。
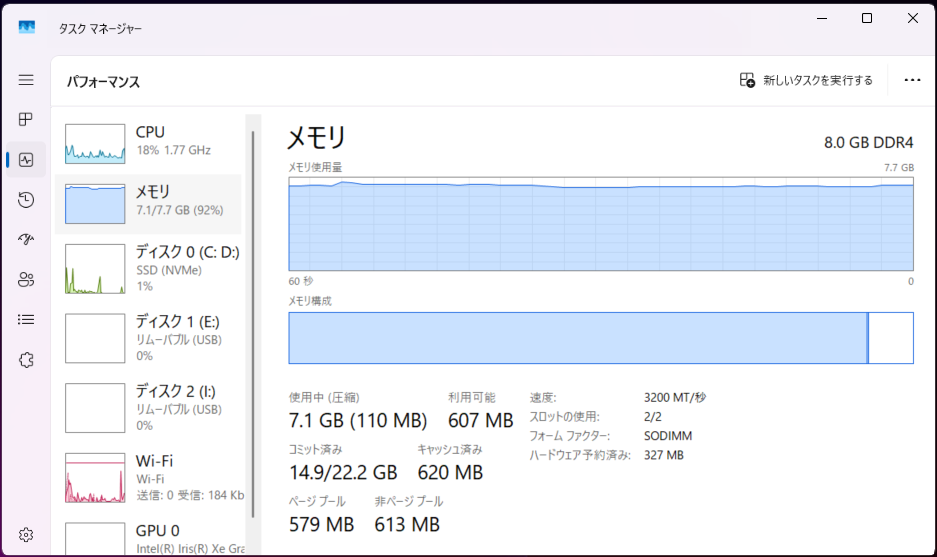
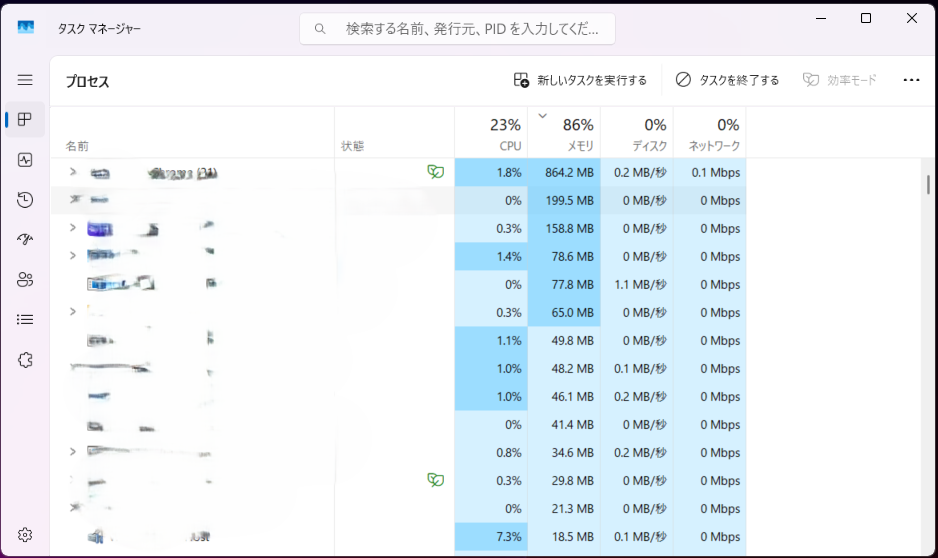
Qwen3 4Bを利用した状態で、
Windowsのタスクマネージャーを確認しました。
結果は、
7.1GB / 7.7GB。
メモリ使用率は、
利用可能メモリは、
607MB。
かなりギリギリです。
ここは実際にやってみて分かりやすかった部分です。
モデルファイルは、
2.50GB。
だから、
8GB RAMなら余裕があるのでは?
と思います。
しかし実際には、
Windows。
LM Studio。
AIモデル。
モデル実行用のメモリ。
内蔵GPU。
セキュリティソフト。
その他のバックグラウンドアプリ。
などが、
すべて同じ8GB RAMを使っています。
つまり、
モデルのファイルサイズ=必要RAM
ではありません。
会社PCなら通常、
ブラウザ。
メール。
Teams。
Office。
業務ソフト。
なども動いています。
実際の仕事中に、
ローカルLLMを使うから、それ以外全部閉じる。
というのは現実的ではありません。
そこで、
もっと小さなモデルを使えばいいのでは?
と考えました。
次に選んだのが、
Qwen3 1.7B
です。
4Bから、
1.7B
まで小さくします。
さらに量子化も選択できます。
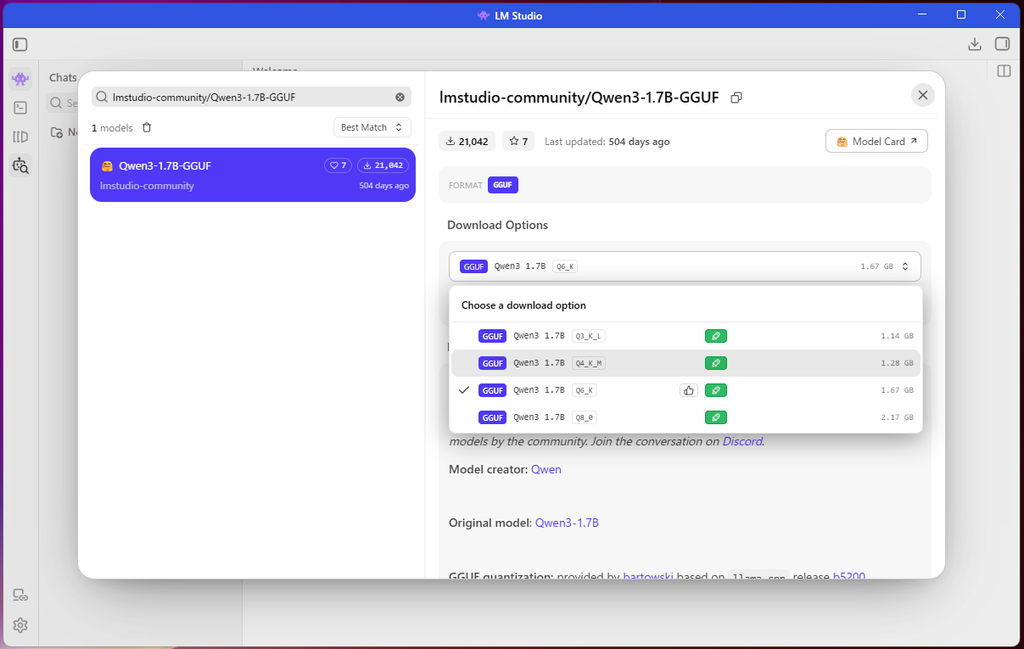
| 量子化 | ファイルサイズ |
|---|---|
| Q3_K_L | 1.14GB |
| Q4_K_M | 1.28GB |
| Q6_K | 1.67GB |
| Q8_0 | 2.17GB |
今回選んだのは、
です。
Qwen3 4Bは、
2.50GB。
Qwen3 1.7B Q4は、
1.28GB。
かなり軽くなりました。
これなら、
さすがに8GB PCでも少し余裕が出るはず。
と思いました。
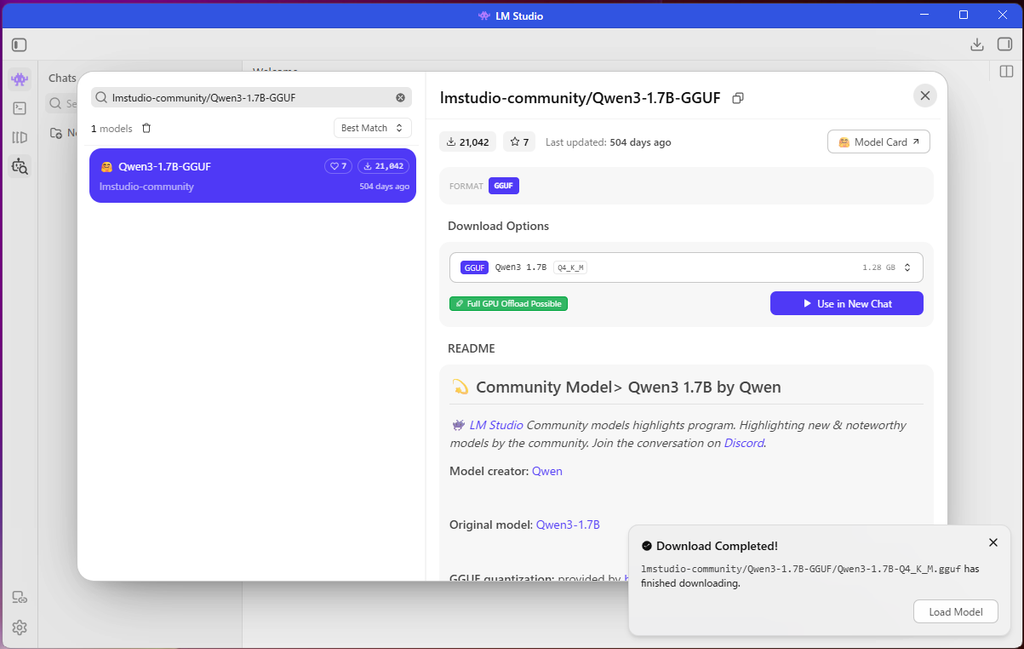
モデルは無事にロードできました。
つまり、
RAM 8GBのPCでもローカルLLMそのものは動かせます。
ここまでは成功です。
では、
メモリはどうなったのでしょうか。
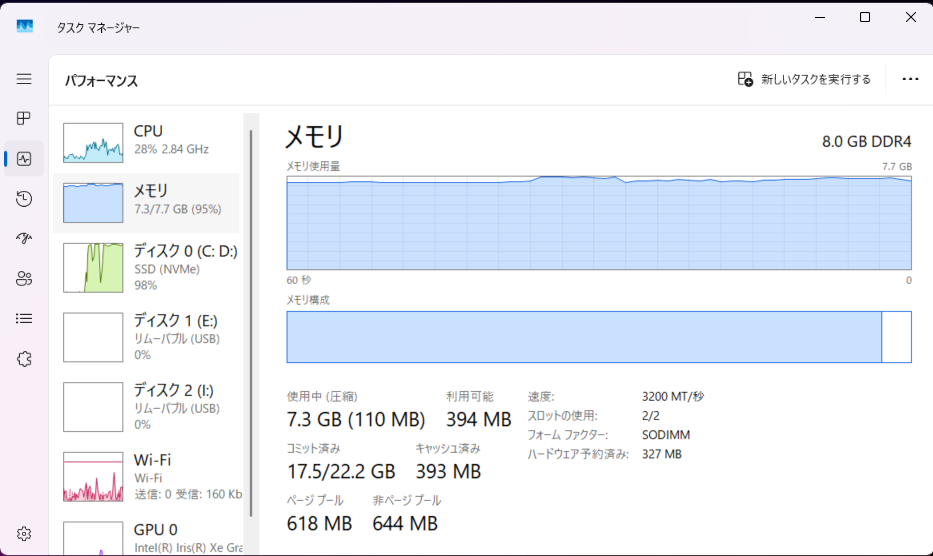
結果は、
7.3GB / 7.7GB。
利用可能メモリ、
394MB。
メモリ使用率、
でした。
これは予想以上でした。
モデルを1.28GBまで小さくすれば、8GBでも余裕になるのでは?
と思っていましたが、
実際にはPC全体のRAMがそもそも少ないため、
ほとんど余裕がありません。
1.28GBのモデルまで小さくしても95%なんだ……
モデルだけがメモリを使うわけじゃないからね。8GBそのものがかなり厳しいラインということが分かる
今回、
Qwen3 4Bでは、
約92%。
Qwen3 1.7Bでは、
約95%。
となりました。
ただし、
1.7Bの方が4Bより重い
という意味ではありません。
測定したタイミングが違い、
Windowsのキャッシュやバックグラウンドプロセスなども同じ状態ではありません。
今回重要なのは、
4Bから1.7Bまでモデルを小さくしても、8GB環境にはほとんど余裕がなかった。
という点です。
ここからが今回の検証で一番重要です。
ローカルLLMを使いたい理由は、
モデルをロードして眺めるためではありません。
普通の会社員なら、
仕事で使いたい。
はずです。
そこで、
ビジネスメールの文章修正
を試しました。
そして今回は、
ChatGPTにもほぼ同じプロンプトを入力
して比較します。
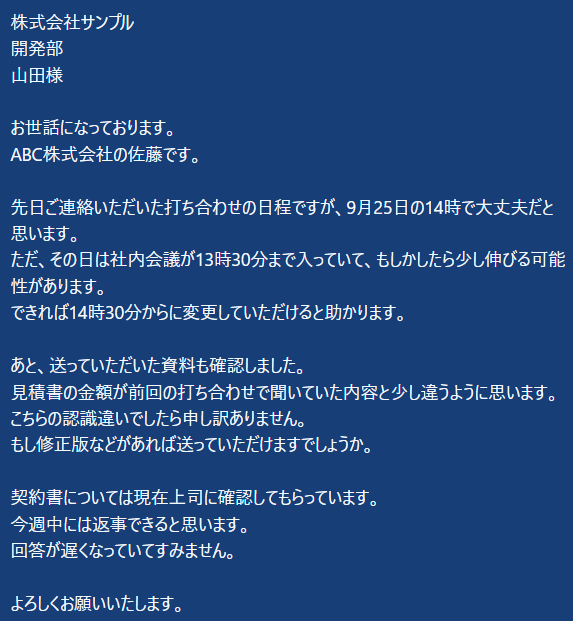
検証では、あえて少し整理されていないメールを用意しました。
内容は、
9月25日の打ち合わせ。
当初14時予定。
しかし13時30分まで社内会議。
できれば14時30分へ変更したい。
さらに、
見積書の金額が前回聞いていた内容と少し違う。
契約書は上司確認中。
今週中に回答予定。
というメールです。
プロンプトでは、
自然で丁寧なビジネスメールに修正すること。
事実関係を変更しないこと。
過度に堅くしないこと。
依頼事項を分かりやすくすること。
原文にない情報を追加しないこと。
を指定しました。
これを、
Qwen3 1.7B
と、
ChatGPT
の両方へ入力しました。
もともとの文章はこちらです。
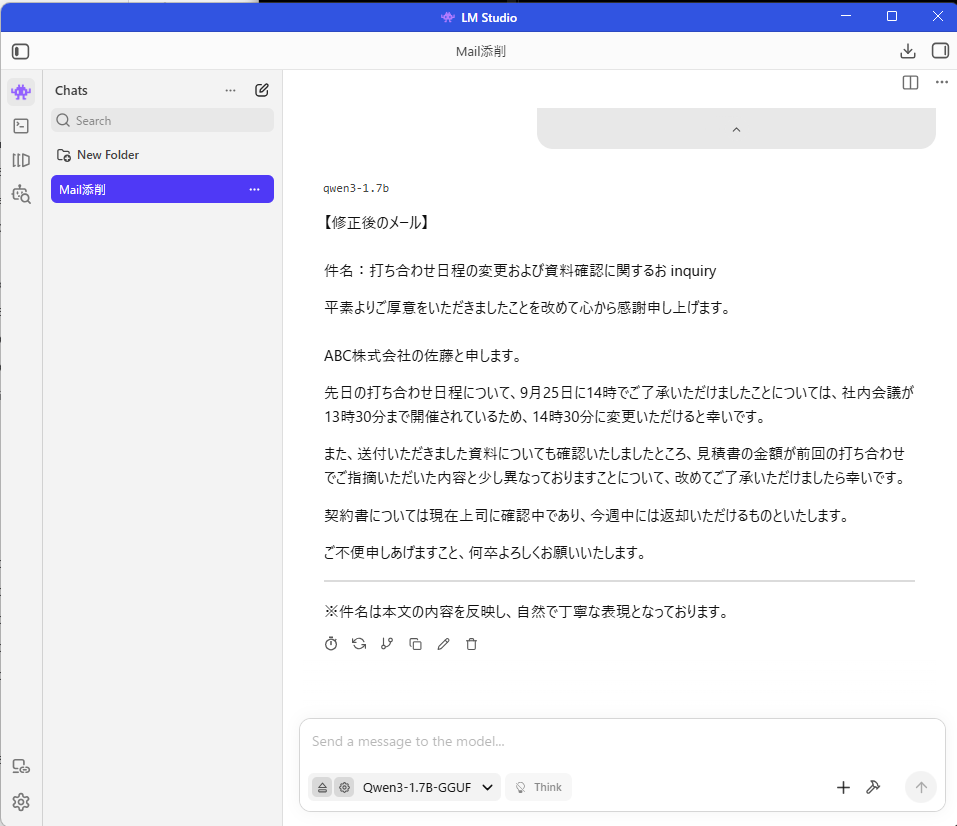
まず、
メールとして文章を作ること自体はできています。
日本語です。
件名も考えています。
内容もある程度整理されています。
しかし、
実際のビジネスメールとして読むと、
いくつか気になる部分がありました。
例えば件名は、
打ち合わせ日程の変更および資料確認に関する inquiry
となっています。
日本語のメール件名の中に、
inquiry
が突然入っています。
さらに冒頭には、
平素よりご厚意をいただきましたことを改めて心から感謝申し上げます。
という表現があります。
間違いとは言い切れませんが、
今回の取引先メールとしてはかなり大げさです。
さらに気になったのが、
9月25日に14時でご了承いただきましたことについては
という文章です。
元のメールは、
「9月25日の14時で大丈夫だと思います」
という内容でした。
相手が14時で正式に了承した、
という事実までは原文にありません。
つまり、
文章を整える過程で、少し意味まで変わっています。
メール修正AIとしては、
ここはかなり注意したい部分です。
Qwen3 1.7Bでは、
見積書の金額が前回の打ち合わせでご指摘いただいた内容と少し異なっておりますことについて
という文章になっています。
しかし元のメールでは、
前回聞いていた金額と少し違うように思う
というニュアンスです。
「ご指摘いただいた内容」という表現へ変更されると、
元文章とは少し意味が変わります。
つまり、
文章を整える能力だけでなく、元文章の意味を維持する能力も重要。
ということが分かります。
次にChatGPTです。
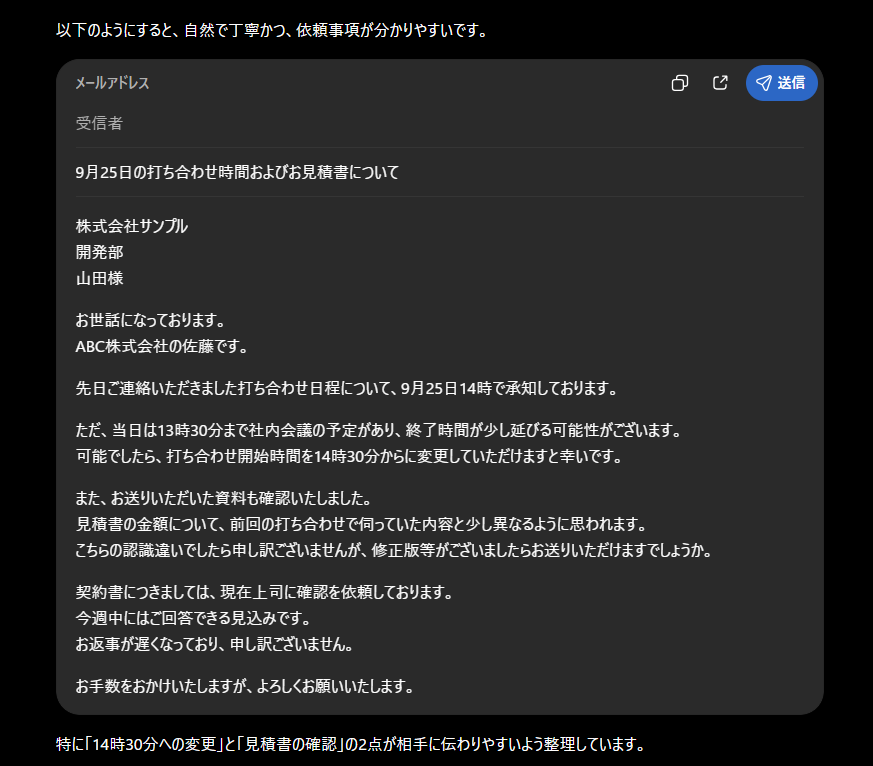
ChatGPTでは件名が、
9月25日の打ち合わせ時間およびお見積書について
となりました。
かなりシンプルです。
本文では、
まず打ち合わせ時刻の変更。
次に見積書。
最後に契約書。
という形に整理されています。
特に、
可能でしたら、打ち合わせ開始時間を14時30分からに変更していただけますと幸いです。
と、
相手へお願いしたいことが明確
になっています。
ChatGPTでは、
見積書の金額について、前回の打ち合わせで伺っていた内容と少し異なるように思われます。
としています。
さらに、
こちらの認識違いでしたら申し訳ございませんが、修正版等がございましたらお送りいただけますでしょうか。
と続きます。
元文章の、
「こちらの認識違いかもしれない」
という配慮を残したまま、
相手へ確認できています。
ここはビジネスメールとしてかなり重要です。
今回の結果を比較すると、
| 比較項目 | Qwen3 1.7B | ChatGPT |
|---|---|---|
| 日本語でメール生成 | ○ | ○ |
| 件名の自然さ | △ | ◎ |
| 敬語 | △ | ◎ |
| 日程変更の分かりやすさ | ○ | ◎ |
| 元文章の意味を維持 | △ | ◎ |
| 見積書への配慮 | △ | ◎ |
| 不自然な表現 | あり | 少ない |
| 追加修正の必要性 | かなりあり | 少ない |
※今回のPC環境、Qwen3 1.7B Q4_K_M、今回使用したメール・プロンプトでのAI Motion Labによる比較です。
今回のローカルLLMも、
メールそのものは作っています。
つまり、
まったく使えない。
という結果ではありません。
例えば、
文章の土台。
メール構成。
アイデア。
といった用途なら参考になります。
ただ、
相手へそのまま送信できる完成形
として見ると、
今回の結果では手直しが必要でした。
特に、
などは、
人間側で確認する必要があります。
最大の理由は、
モデルそのものが違う
からです。
今回ローカルで使ったのは、
Qwen3 1.7B。
かなり小さなモデルです。
しかも8GB PCで動かすために、
Q4_K_M
へ量子化しています。
一方、
ChatGPTはクラウド上の非常に大きな計算資源を利用しています。
ですから、
同じプロンプトを入力したら同じ程度の文章が出てくる
と考える方が無理があります。
今回、
同じようなメール。
同じようなプロンプト。
で比較したことで、
かなり分かりやすい結果になりました。
8GB PCでも、
AIは動く。
日本語も返す。
メールも作る。
でも、
仕事で欲しいのは「文章が出ること」ではなく、「手直しせずに使える文章が出ること」。
です。
この差は大きいと思います。
【吹き出し:朝比奈ミオ】
「ローカルLLMでもメールは作れた。でも結局、送る前にかなり確認が必要なんだね」
【吹き出し:黒崎リン】
「そう。今回の1.7Bでは“下書きを作るAI”として考えた方がいい。完成品を期待するとChatGPTとの差を感じる」
今回の結果だけで考えるなら、
私は、
おすすめしません。
理由は単純です。
Qwen3 1.7Bを動かす。
↓
RAM最大95%。
↓
メールを生成。
↓
さらに人間が修正。
という流れになります。
それなら、
ChatGPTへ入力。
↓
かなり完成形に近い文章。
の方が、
仕事の効率化という意味では圧倒的に簡単
でした。
そんなことはありません。
今回の記事で試しているのは、
RAM 8GBのPC。
です。
16GB。
32GB。
あるいはGPUを搭載したPCなら、
もっと大きなモデルを利用できます。
モデル性能が上がれば、
文章品質も改善する可能性があります。
つまり今回分かったのは、
ローカルLLMの限界ではなく、8GB PCで現実的に動かせる小型モデルの限界。
です。
今回の検証結果を踏まえると、
8GB環境では、
完成品を作らせるより、補助的な使い方
の方が向いていると感じました。
短い文章の要約。
箇条書きへの整理。
簡単な言い換え。
アイデア出し。
文章のたたき台。
そして、
ローカルAIそのものを勉強する。
こうした用途です。
今回、
4B。
↓
1.7B。
までモデルを小さくしました。
それでも、
最大95%。
です。
8GBでは、
Windows。
ブラウザ。
メール。
Office。
などとローカルLLMを同時利用するには余裕がありません。
今回の実体験からAI Motion Labでは、
| RAM | 使い方のイメージ |
|---|---|
| 8GB | 体験・学習 |
| 16GB | 実用性を試し始める |
| 32GB | モデルの選択肢が増える |
| GPU+十分なVRAM | さらに大きなモデル・高速推論 |
くらいで考えると分かりやすいと思います。
今回使用したPCは、
Core i5-1235U
RAM 8GB
Intel Iris Xe Graphics
という環境です。
このPCでも、
LM Studioをインストール。
Qwen3 4Bをダウンロード。
モデルを起動。
さらに、
Qwen3 1.7Bも起動。
できました。
つまり、
普通のPCでもローカルLLMを体験することはできる。
これは確認できました。
一方、
Qwen3 4Bで、
メモリ約92%。
1.7Bまで小さくしても、
最大95%。
さらに、
ビジネスメール修正では、
ChatGPTの方がかなり自然で、そのまま使いやすい。
という結果でした。
最初の質問に戻ります。
普通の会社PCでローカルLLMは使える?
今回の答えは、
です。
LM Studioそのものの導入は簡単。
ローカルLLMも起動しました。
日本語も返ってきます。
メールも作れます。
ですから、
「高性能GPUがないとローカルLLMは一切使えない」
というわけではありません。
しかし、
Qwen3 4B。
↓
メモリ約92%。
さらに、
Qwen3 1.7B Q4。
↓
メモリ最大95%。
でした。
しかも今回、
同じようなメール文章修正をChatGPTと比較した結果、
仕事でそのまま使える文章を作る能力ではChatGPTの方がかなり上
と感じました。
だから今回の結論は、
RAM 8GBの普通の会社PCは、ローカルLLMを「体験する」ことはできる。
でもChatGPTの代わりとして仕事へ本格導入するには、かなり厳しい。
です。
結局、8GB PCでもAIは動いた。でもChatGPTを置き換えるところまでは行かなかったんだね
そう。でもこの結果が分かっただけでも大きい。次は16GB、32GB、GPUありでどこまで変わるか。それがローカルLLMの面白いところ
ローカルLLMを始めたいからといって、
最初から高性能PCを買う必要はありません。
まず、
自分のPCで小さなモデルを動かしてみる。
そして、
メモリが足りない。
速度が遅い。
文章品質が足りない。
と感じてから、
PCスペックやモデルを見直す。
その順番でも十分です。
今回の8GB PCは、
ローカルAIの入口には立てました。
でも、
仕事で本格的に使うなら、もう少し先へ進む必要がありそうです。
広告