AI Motion Lab おすすめガジェット
仕事・ローカルLLM・REDMAGIC Astra 2・ゲーム環境で役立つガジェットを、Amazonストアフロントにまとめています。
AI Motion Labの記事で紹介しているPC周辺機器や、実際に使っている・気になるアイテムをテーマ別に探せます。
※当サイトはAmazonアソシエイト・プログラムを利用しています。
「何十ページもあるPDFから、必要な箇所だけ探したい」
「社内マニュアルや取扱説明書の内容を、AIに質問できるようにしたい」
そんなときに役立つのが、LM Studio BionicとRAGを組み合わせたPDF検索です。
先に結論を言うと、文字を選択できるPDFであれば、BionicのProjectへ追加し、資料に基づく要約・比較・質問回答を行えます。
ただし、PDFを追加するだけで必ず正確な回答が得られるわけではありません。スキャンPDFにはOCRが必要になる場合があり、質問が曖昧だと関係のない箇所が選ばれることもあります。
この記事では、RAGの意味からBionicへのPDF追加手順、コピーして使える質問文、回答精度を確かめる方法まで、初心者向けに説明します。
この記事の結論
最初は、内容をよく知っているPDFを1冊だけ追加してください。「本文にある質問」と「本文にない質問」を両方試し、Bionicが“書かれていないこと”を正しく判断できるか確認するのが重要です。
広告

RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と呼ばれます。
簡単に言うと、AIが質問に関係する文章を資料から探し、その文章を根拠に回答を作る仕組みです。
通常のLLMは、学習時に覚えた知識と、会話画面へ入力された情報を使って回答します。しかし、手元にある社内資料や購入した製品の説明書までは知りません。
そこでRAGでは、質問を受けたあとに資料を検索し、見つかった文章をLLMへ渡します。
質問
  ↓
PDFから関係する箇所を検索
  ↓
検索結果をLLMへ渡す
  ↓
資料に基づいた回答を生成イメージとしては、AIにPDFを丸暗記させるのではなく、質問のたびに索引を使って必要なページを開かせる方法です。
LM Studioの公式ドキュメントでは、短い文書は全文をモデルのコンテキストへ入れ、長い文書ではRAGを使って関連箇所を取り出すと説明されています。
コンテキストとは、LLMが一度に読みながら考えられる「作業机」のようなものです。
| PDFの状態 | 主な処理イメージ |
|---|---|
| 短く、全文がコンテキストに収まる | PDFの文章をまとめてモデルへ渡す |
| 長く、全文が収まらない | 質問に近い箇所を検索してモデルへ渡す |
そのため、PDFを追加したからといって、すべての質問で必ずベクトル検索が行われるとは限りません。読者が本当に必要なのは内部方式の名前ではなく、長いPDFから関係箇所を取り出し、根拠付きで答えられることです。
広告
ここは少し紛らわしいため、先に整理しておきます。
LM Studioの公式ドキュメントで「RAG」と明記されているのは、LM Studioアプリの「Chat with Documents」です。一方、BionicはPDFなどのファイルをProjectへ追加し、AIエージェントに調査、要約、比較、成果物作成を依頼するアプリとして案内されています。
この記事では、Bionicで自分のPDFから必要な情報を探し、回答や資料作成へ利用する流れを、広い意味で「Bionic × RAG」と表現しています。
| 比較項目 | LM Studio | LM Studio Bionic |
|---|---|---|
| 得意なこと | PDFを添付して質問する | PDFを調査し、比較表や報告書まで作る |
| 公式上の表現 | Chat with Documents/RAG | Documents and Filesを扱うAIエージェント |
| 資料の管理 | チャット単位で添付 | Project内でファイルを共有 |
| 向いている人 | まずPDFへ質問したい人 | PDF検索を仕事の流れへ組み込みたい人 |
単純にPDFへ質問したいだけならLM Studio、複数資料から報告書や一覧表を作りたいならBionicと考えると選びやすくなります。
準備するものは次の3つです。
Bionicはローカルモデルだけでなく、別端末のモデルを使うLM Linkやクラウドモデルにも対応しています。
機密性を優先する場合はLocal、手元のPC性能が足りない場合はLM Link、重い処理や高い精度を優先する場合はCloudという選び方ができます。ただし、会社資料を扱う場合は、会社が許可した実行方法だけを使用してください。
最初に、PDFを開いて文章をマウスで選択できるか確認します。
選択した文章をメモ帳へコピーできれば、テキスト情報を持つPDFです。そのまま扱える可能性が高いでしょう。
文章を選択できず、1ページ全体が画像のようになっている場合は、紙をスキャンして作ったPDFかもしれません。この場合は、OCRで画像から文字を読み取る前処理が必要になることがあります。
| PDFの種類 | 見分け方 | 対応 |
|---|---|---|
| テキストPDF | 文章を選択・コピーできる | そのまま追加する |
| スキャンPDF | 文章を選択できない | OCR後のPDFまたはテキストへ変換する |
| 表・図が中心 | 文字は少なく、画像で情報を表現 | 画像対応モデルを検討し、結果を目視確認する |
| パスワード付きPDF | 開くときに認証を求められる | 権限を確認し、許可された方法で解除・複製する |
OCRには読み間違いがあります。数字、日付、製品型番、薬剤名など、1文字の違いが問題になる情報は原本と照合してください。
Bionicを起動したら、新しいProjectを作成します。
たとえば、次のように目的別で分けます。
PDF-Knowledge/
├─ manuals/       # 取扱説明書
├─ rules/         # 規程やガイドライン
├─ reports/       # 報告書
└─ answers/       # Bionicが作成した回答や比較表
Project名は「PDF検索」よりも、「就業規則」「製品マニュアル」「調査資料」など、扱う内容がわかる名前がおすすめです。
異なるテーマのPDFを大量に混ぜると検索対象が広くなり、似た用語を含む別資料が選ばれる可能性があります。最初は1つのProjectに1テーマを目安にします。
検索したいPDFをBionicへドラッグ&ドロップするか、ファイル追加機能から選びます。
Project Filesへ追加したファイルは、同じProject内のSessionで共有できます。そのため、次のように作業を分けられます。
ファイル名は、内容と版数がわかるようにしておくと便利です。
製品A_取扱説明書_第3版_2026-09.pdf
情報管理規程_2026-04改訂.pdf
プロジェクト月次報告_2026-10.pdf
「manual.pdf」「資料1.pdf」のような名前では、回答の根拠を確認するときに迷います。
いきなり難しい質問をせず、まず次のように依頼します。
Project FilesにあるPDFについて、次の項目を一覧にしてください。

- ファイル名
- 文書タイトル
- 発行元
- 発行日または改訂日
- ページ数
- 主な見出し
- 文字を正しく読み取れないページの有無

確認できない項目は推測せず「確認できない」と記載してください。
タイトルや見出しが原本と一致すれば、基本的なテキスト抽出はできています。文字化け、見出しの欠落、ページ順の乱れがある場合は、PDFをOCRし直すか、テキストやMarkdownへ変換してから追加します。
最初の質問には、次の4点を含めます。
「情報管理規程_2026-04改訂.pdf」だけを根拠に回答してください。

外部へのファイル持ち出しに関する規定を探し、次の形式でまとめてください。

1. 結論
2. 対象となる行為
3. 禁止事項
4. 例外や承認手続き
5. 根拠となる見出しとページ番号

PDF内で確認できない内容は推測せず、「記載を確認できない」と答えてください。Project Files内の「第2版」と「第3版」のPDFを比較してください。
- 追加された内容
- 削除された内容
- 表現だけが変更された内容
- 業務への影響が大きい変更
変更点ごとに、両方のファイル名とページ番号を付けてください。
判断できない箇所は推測せず、要確認として分けてください。このPDFから「データ保存期間」「廃棄」「バックアップ」に関係する箇所を探してください。
完全一致する言葉だけでなく、同じ意味の表現も確認してください。
回答は、要点、対象者、期限、例外、根拠ページの順でまとめてください。LM Studioの公式ドキュメントでも、RAGでは質問に関連しそうな用語や考え方を具体的に含めると、役立つ箇所を取得しやすいと案内されています。
「このPDFを要約して」だけでなく、「誰が、いつまでに、何をするか」「○○と同じ意味の表現も探す」と指定することが大切です。
同じ形式で何度もPDFを検索するなら、検索ルールをSkillにしておくと便利です。
以下は、そのままたたき台として使えるSKILL.mdです。
---
name: pdf-source-search
description: Project Files内のPDFを検索し、根拠を明示した回答を作成する
---

# 目的
利用者の質問に関係する箇所をPDFから探し、資料に基づく回答を作る。

# 手順
1. 質問で指定されたPDFを確認する。
2. 指定がない場合は、検索に使用するPDF候補を先に示す。
3. 質問に含まれる用語と同義語で関係箇所を探す。
4. 複数の記載がある場合は、新しい版を優先する前に版数を利用者へ確認する。
5. 回答と根拠を分けて出力する。

# 出力形式
## 結論
## 根拠
| ファイル名 | 見出し | ページ | 要点 |
|---|---|---|---|
## 確認できなかったこと
## 人が原本を確認すべき点

# ルール
- PDFに書かれていない内容を補完しない。
- ページ番号を取得できない場合は「ページ確認不可」と記載する。
- 推測が必要な場合は回答へ混ぜず、推測として分ける。
- 同名ファイルや複数版がある場合は勝手に選ばない。
- 数字、日付、金額、固有名詞は原文と照合するよう注意を出す。
- 「記載がない」と「検索で見つけられない」を区別する。使用時は、入力欄で@を入力してSkillを選びます。
@pdf-source-search
製品Aの保証対象外となる条件を調べてください。
保証期間、消耗品、水濡れ、改造の扱いを表にしてください。PDF検索を仕事で使う前に、簡単なテストを行います。
原本を読めば答えがわかる質問を作ります。
Bionicの回答と、原本の記載を比較します。
RAGで重要なのは、答えられることだけではありません。
資料にない質問へ「記載を確認できない」と答えられるかを確認します。もっともらしい内容を作ってしまう場合は、Skillへ「PDFにないことは答えない」というルールを追加します。
PDFでは「削除」、質問では「廃棄」のように、異なる言葉で同じ意味を表すことがあります。
専門用語、略語、旧名称、言い換えでも該当箇所を探せるか確認します。
回答が正しく見えても、引用元が別の条件を説明している可能性があります。重要な判断では、必ずファイル名とページを開いて原文を確認してください。
とくに効果が大きいのは、質問対象を絞ることです。
「全部のPDFから安全について教えて」ではなく、「情報管理規程のうち、USBメモリへの保存と社外持ち出しに関する記載を探して」と聞くほうが、検索意図が伝わります。
8GB・GPUなしのPCは、LM StudioのWindows推奨要件である16GB RAMを下回ります。そのため、PDF検索は小さく試す必要があります。
| PC環境 | モデルの目安 | PDF検索の始め方 |
|---|---|---|
| RAM 8GB・GPUなし | Qwen3.5 2B、余裕があれば4B | 短いテキストPDFを1冊、質問を1つずつ |
| RAM 16GB前後 | 4B〜9B級 | 数冊のPDFから要約・比較 |
| RAM 32GB・RTX 3060 12GB | 9B級を中心に比較 | 複数資料の横断検索や報告書作成 |
8GB環境では、次の点を意識します。
大きなモデルが必ず必要なわけではありません。検索で適切な文章を取得できれば、小型モデルでも要約や項目抽出に使えます。ただし、複数条件の判断や表の読み取りではモデル性能の差が出やすいため、原本確認は必要です。
LM Studioの公式ドキュメントでは、ローカルモデルを使った文書チャットはオフラインで動作し、追加した文書は端末内で処理されると説明されています。
ただし、次の機能を使う場合はデータの流れが変わります。
機密資料を扱う場合は、ローカルモデルを選ぶだけでなく、Web Searchや外部連携が無効になっていることも確認します。
また、技術的にローカル処理できても、会社で利用できるとは限りません。社内規程、アプリのインストール許可、資料の保存場所を確認してください。
患者情報、顧客情報、未公開の契約書、研究データなどは、組織の承認を得るまで投入しないほうが安全です。
数十ページの資料から、期限、対象者、禁止事項などを先に抽出できます。人は該当ページを確認することに集中できます。
旧版と新版、複数製品の説明書、月ごとの報告書などを表で比較できます。
Bionicでは、検索結果を要約するだけでなく、Markdownの報告書、比較表、説明資料などのファイル作成へつなげられます。
モデルと資料を端末内に置けば、インターネットへ接続せずに文書質問を行える構成を作れます。
RAGは全文を毎回読む仕組みではありません。質問と検索語が曖昧だと、重要な文章が取得されない場合があります。
画像だけのPDF、段組み、注釈、細かい表では、文字抽出や読む順番が崩れることがあります。
LLMは自然な文章を作るため、根拠が弱くても自信のある表現になる場合があります。根拠ファイルとページの表示を必須にします。
旧版と新版が混在すると、古い規定を根拠に答える可能性があります。版数、改訂日、廃止資料を管理しなければなりません。
いいえ。RAGはPDFの内容をモデルへ再学習させる方法ではありません。質問のたびに関係する文章を探し、回答の材料として渡します。PDFを削除してもモデル自体の知識が元に戻るわけではなく、そもそもモデルへ恒久的に覚え込ませているわけではありません。
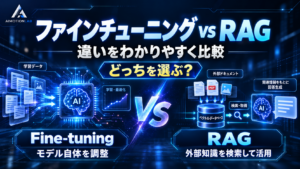
RAGは外部資料を検索して内容を答える方法です。ファインチューニングは、例文などを使ってモデルの振る舞いや回答傾向を調整する方法です。頻繁に更新される規程やマニュアルの検索には、差し替えやすいRAGが向いています。
追加できる数だけでなく、PDFの容量、ページ数、画像量、PC性能、質問の範囲が影響します。最初は1〜3冊で検証し、正しく検索できることを確認してから増やしてください。
文字情報を持たないスキャンPDFは、そのままでは検索精度が落ちます。OCR処理を行い、文章を選択できるPDFまたはテキストへ変換してから追加するのが確実です。
1冊のPDFへ質問するだけなら、LM StudioのChat with Documentsが簡単です。複数資料を継続的に管理し、比較表や報告書まで作りたい場合はBionicが向いています。
LM Studio Bionicを使えば、自分のPDFをProjectへ追加し、必要な情報の検索、要約、比較、報告書作成へつなげられます。
ただし、RAGは「PDFを入れれば何でも正しく答える仕組み」ではありません。
この4点を検証する必要があります。
最初の一歩として、内容をよく知っているPDFを1冊追加し、次の3つを質問してみてください。
答えを出せることより、根拠がないときに「わからない」と止まれること。
これを確認できれば、Bionic × RAGを仕事へ取り入れる準備が整います。
広告