AI Motion Lab おすすめガジェット
仕事・ローカルLLM・REDMAGIC Astra 2・ゲーム環境で役立つガジェットを、Amazonストアフロントにまとめています。
AI Motion Labの記事で紹介しているPC周辺機器や、実際に使っている・気になるアイテムをテーマ別に探せます。
※当サイトはAmazonアソシエイト・プログラムを利用しています。
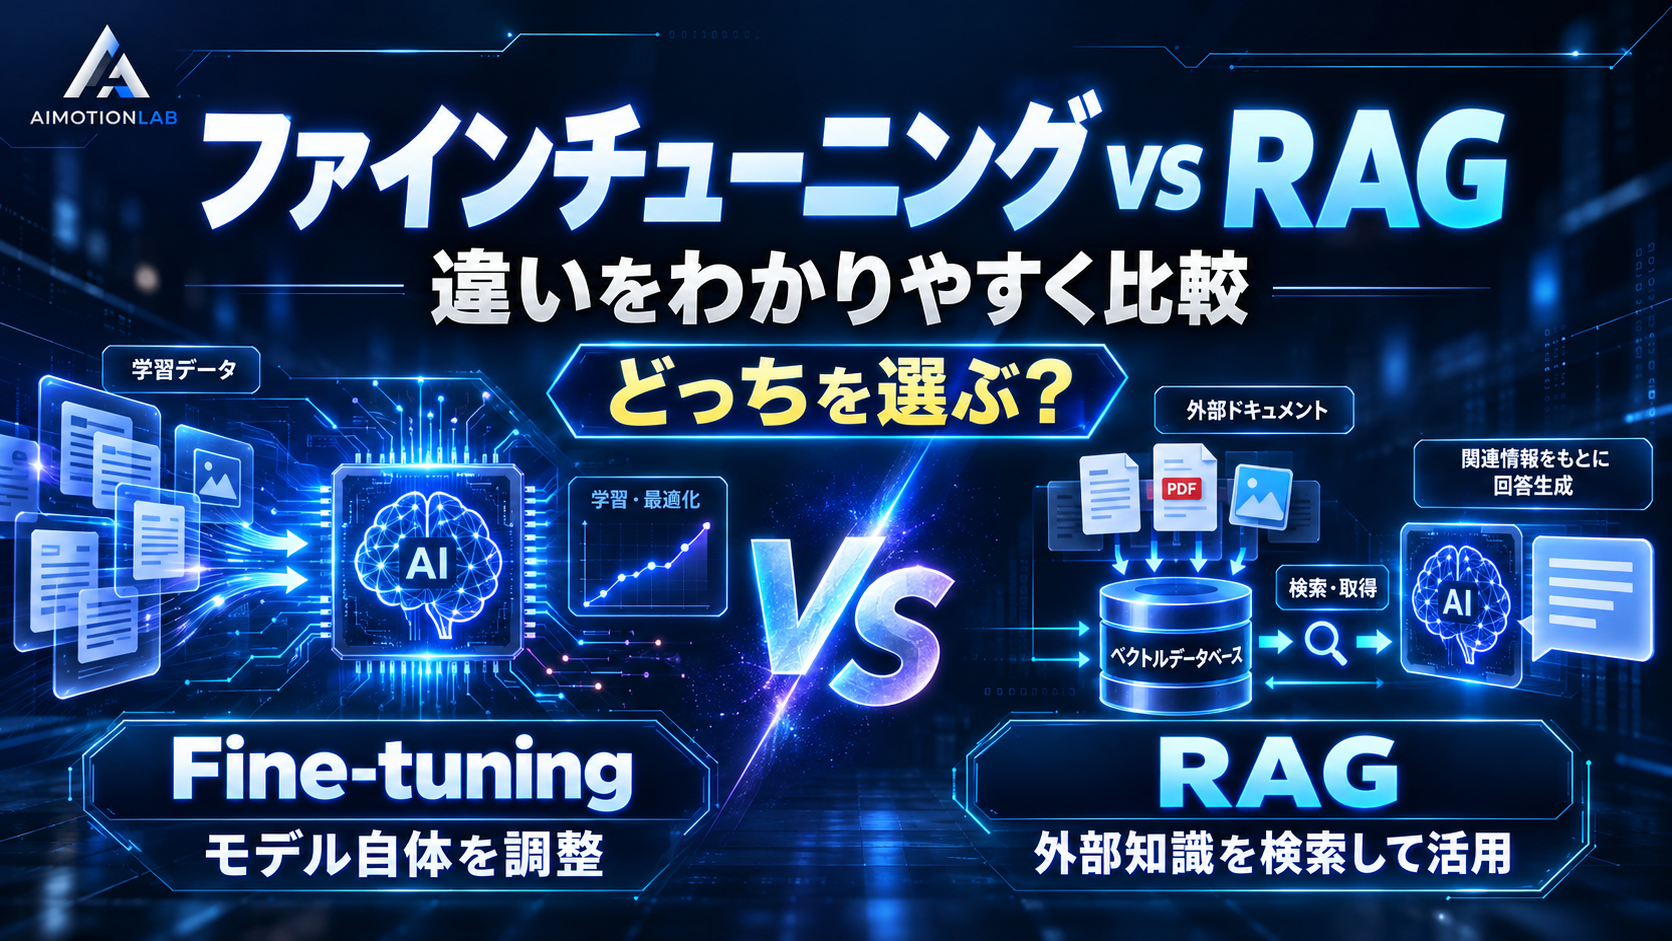
生成AIに自社の資料を覚えさせたいと考えたとき、よく候補に挙がるのが「ファインチューニング」と「RAG」です。
どちらも既存のLLMを特定の用途に合わせる技術ですが、仕組みも得意分野も大きく異なります。
最初に結論をまとめると、次のように考えると分かりやすいです。
社内文書や最新情報を参照して答えさせたいならRAG、回答の書き方・形式・判断パターンを身につけさせたいならファインチューニングが向いています。
「大量のPDFを学習させたい」という理由だけで、すぐにファインチューニングを選ぶ必要はありません。文書の内容を根拠に回答させる用途では、多くの場合RAGの方が更新しやすく、情報源も確認しやすいからです。
この記事では、ファインチューニングとRAGの意味、違い、メリット・デメリット、選び方を初心者向けに解説します。
広告

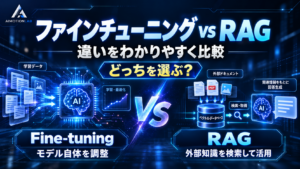
ファインチューニングとRAGの最も大きな違いは、モデル自体を追加学習させるか、回答時に外部資料を検索して渡すかです。
| 比較項目 | ファインチューニング | RAG |
|---|---|---|
| 基本的な仕組み | 学習データを使ってモデルの重みを調整する | 質問に関連する外部資料を検索し、回答時の文脈として渡す |
| 主な目的 | 回答のスタイル、形式、振る舞い、特定タスクの精度を調整する | 独自情報や最新情報を根拠に回答させる |
| 情報の保存場所 | 主にモデルのパラメーター | 文書、データベース、ベクトルストアなどの外部データ |
| 情報更新 | 原則として再学習が必要 | 元データやインデックスを更新すればよい |
| 出典の表示 | 苦手 | 参照文書と結び付けやすい |
| 導入時の負担 | 学習データ作成、学習、評価が必要 | 文書整理、分割、検索基盤の構築が必要 |
| 回答時の処理 | 学習後は比較的シンプル | 検索処理が加わるため構成が複雑になりやすい |
| 向いている例 | 定型文、分類、独自の文章スタイル、決まった出力形式 | 社内規程、製品情報、マニュアル、FAQ、最新データ |
一言で表すなら、次の違いです。
ファインチューニングとは、すでに学習済みのAIモデルに追加の学習データを与え、特定の用途に適した回答を出せるよう調整する方法です。日本語では「微調整」と呼ばれます。
たとえば、次のような入力と理想的な出力の組み合わせを多数用意します。
入力:会議は10月20日です。資料は前日までに提出してください。

理想の出力:
タスク:会議資料を提出する
期限:10月19日
状態:未着手
このような例を繰り返し学習させることで、モデルは「メールからタスクを抽出し、指定した形式で答える」という振る舞いを身につけていきます。
なお、ローカルLLMで使われるLoRAやQLoRAも、モデル全体ではなく一部の追加パラメーターを効率よく学習させる手法です。比較的少ない計算資源で調整できますが、良質な学習データと評価が重要である点は変わりません。
広告
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と呼ばれます。
ユーザーから質問を受けたときに、登録済みの文書から関連部分を検索し、その内容をLLMへ渡して回答を作らせる仕組みです。
一般的なRAGは、次の流れで動きます。
たとえば、社内の就業規則をRAGへ登録しておけば、「育児休業の申請期限はいつですか」と質問された際に、関連する規程を検索して回答できます。
RAGでは、元のLLMそのものを再学習させるわけではありません。必要な知識を回答時に「参考資料」として渡す点が、ファインチューニングとの大きな違いです。
ファインチューニングは、学習例を使ってモデルのパラメーターを調整します。一方、RAGは外部に保存した資料から必要な情報を探し、回答時にモデルへ渡します。
そのため、社内規程や製品マニュアルを参照させたい場合はRAG、特定の書式や回答パターンを定着させたい場合はファインチューニングが適しています。
料金、在庫、法律、製品仕様など、頻繁に変わる情報はRAGが有利です。元データと検索用インデックスを更新すれば、新しい情報を回答に反映できます。
ファインチューニングで覚えさせた内容を変えるには、新しい学習データを用意して再度調整する必要があります。変化の速い事実を管理する用途には向きません。
RAGは、検索した文書名や該当箇所を回答と一緒に表示しやすい仕組みです。利用者は「何を根拠にした回答なのか」を確認できます。
ファインチューニングでは、回答がどの学習例に由来するのかをその場で特定することは困難です。根拠資料の提示が必要な業務では、RAGの方が設計しやすいでしょう。
ただし、RAGを使えば必ず正しい出典が付くわけではありません。検索結果の選び方や回答ルールが不適切であれば、関係のない資料を参照したり、資料にない内容を補ってしまったりする可能性があります。
ファインチューニングには、単なる資料の山ではなく、基本的に「入力に対する理想的な出力」の例が必要です。データの品質が低いと、望ましくない癖まで学習するおそれがあります。
RAGでは、検索対象となる文書の整理が重要です。文章をどこで区切るか、表や画像をどう扱うか、どの検索方式を使うかによって精度が大きく変わります。
RAGは知識不足の改善に向き、ファインチューニングは振る舞いの改善に向きます。
この区別をしておくと、必要のない追加学習に時間と費用をかける失敗を減らせます。
正しい回答例を学習させることで、文章のトーン、項目の並び、分類方法などを一定にしやすくなります。大量の定型処理を繰り返す業務と相性がよい方法です。
汎用モデルが苦手とする独自の分類や定型変換でも、十分な品質の学習例があれば改善を期待できます。
毎回、長い指示や大量の見本を入力している場合、そのパターンを学習させることでプロンプトを短縮できる可能性があります。運用条件によっては、入力トークン数や応答時間の削減にもつながります。
限定された業務であれば、大型モデルを毎回使うのではなく、小型モデルを特定タスク向けに調整する選択肢があります。ローカルLLMの活用でも注目される方法です。
学習用データは、量だけでなく一貫性と正確性が重要です。誤った回答、表記揺れ、矛盾した判断例が混ざると、期待した結果にならないことがあります。
データ作成、学習の実行、性能評価、修正、再学習という工程が必要です。ローカル環境で行う場合は、GPUやメモリなどの計算資源も検討しなければなりません。
情報が変わるたびに追加データを作成して再学習するのは非効率です。頻繁に更新される事実を扱うなら、RAGや外部ツールとの連携が向いています。
モデルが返した答えについて、どの学習データを根拠にしたのかを直接示すことは困難です。監査性や説明責任を重視する業務では注意が必要です。
学習データや設定が適切でないと、特定の表現に偏ったり、もともとできていた一般的な応答が不安定になったりすることがあります。学習前後を同じ評価セットで比較する作業が欠かせません。
社内文書、マニュアル、製品データなど、基盤モデルが学習していない情報を回答時に渡せます。資料の追加や差し替えにも対応しやすい方法です。
文書の入れ替えや検索インデックスの更新で対応できるため、モデルを再学習するより変更を反映しやすくなります。
回答に使用した文書名、URL、ページ番号などを表示する設計が可能です。回答を人が確認する業務では大きなメリットになります。
部署、役職、契約状態などに応じて検索対象を分ければ、閲覧権限に沿った回答システムを構築できます。ただし、検索結果と生成結果の両方に権限管理を適用する必要があります。
知識を外部データとして管理するため、同じ検索基盤を活用しながら、用途に合わせて別のLLMを試しやすい点も利点です。
必要な情報が登録されていても、適切な箇所を取得できなければ回答精度は上がりません。RAGでは、LLMの性能だけでなく検索精度が結果を左右します。
文章を細かく分けすぎると文脈が失われ、大きく分けすぎると不要な情報まで渡してしまいます。表、画像、注釈、ページをまたぐ説明なども工夫が必要です。
文書の取り込み、検索、権限管理、LLMへの受け渡し、ログ管理など、モデル以外の仕組みが必要です。小規模な検証は簡単でも、業務運用では保守する対象が増えます。
回答前の検索処理と、検索結果を含む長い入力が追加されます。そのため、単純なチャットより応答時間やトークン使用量が増えることがあります。
登録文書に誤情報や悪意ある指示が含まれていると、回答へ影響する可能性があります。参照データの管理、指示と資料の分離、出力検証などの対策が必要です。
迷った場合は、解決したい問題が「知識不足」なのか「振る舞いの不安定さ」なのかを確認します。
| やりたいこと | おすすめ |
|---|---|
| 社内マニュアルを検索して回答したい | RAG |
| 最新の製品価格や仕様を答えたい | RAG |
| 回答に出典を表示したい | RAG |
| 頻繁に更新される情報を扱いたい | RAG |
| メールを独自カテゴリへ分類したい | ファインチューニング |
| 毎回同じJSON形式で出力したい | ファインチューニング |
| 自社独自の文章トーンを安定させたい | ファインチューニング |
| 長い指示と回答例を毎回入力したくない | ファインチューニングを検討 |
| 最新資料を参照し、決まった形式で回答したい | RAG+ファインチューニング |
いきなりファインチューニングへ進むのではなく、まず指示文と少数の回答例で改善できないかを確かめるのが重要です。ファインチューニングには、学習前後の効果を測る評価データも必要になるためです。
この場合はRAGが第一候補です。
就業規則や申請手順は更新される可能性があり、回答の根拠も確認できる必要があります。規程を外部データとして管理し、該当箇所を検索して回答させる方が適しています。
「契約」「請求」「故障」「解約」など、自社独自の分類基準があり、十分な正解例を用意できるならファインチューニングが候補になります。
ただし、最初はプロンプトと数件の見本だけで精度を確認し、それでも安定しない場合に進むのがよいでしょう。
最新マニュアルやFAQを参照する部分にはRAGが向いています。さらに、必ず確認事項を聞く、指定フォーマットで案内するなど、回答手順を安定させたい場合はファインチューニングを組み合わせる余地があります。
文章の語調や構成を再現したい場合は、ファインチューニングが選択肢になります。
ただし、少量の文章しかない場合は、プロンプトに文体ルールと見本を入れるだけで十分なこともあります。個人利用では、最初から追加学習するより、プロンプトやSkillで再現性を確認する方が手軽です。
この用途は基本的にRAGです。PDFの内容をモデルへ再学習させるのではなく、質問に関係する箇所を検索してローカルLLMへ渡します。
一方、「常に決まった項目で要約する」「社内の分類基準で判定する」といった振る舞いを小型モデルへ定着させたい場合は、LoRAなどのファインチューニングを検討できます。
RAGとファインチューニングは、どちらか一方しか選べない技術ではありません。
たとえば、RAGで最新の社内資料を取得し、ファインチューニング済みモデルで決められた書式の回答を作る構成が考えられます。
ただし、併用すれば自動的に精度が上がるわけではありません。検索の評価と生成結果の評価を分けて行い、どこで失敗しているかを確認できる設計が必要です。
「何となく良くなった」で判断せず、想定質問と正解、期待する出力形式を用意します。RAGなら検索できたかと正しく回答できたか、ファインチューニングなら形式やタスク精度が改善したかを分けて評価します。
社内文書や個人情報を扱う場合は、クラウドへ送信してよいデータか、ローカル環境が必要か、ログに何が残るかを確認します。RAGでもファインチューニングでも、導入前に組織の情報管理ルールを確認してください。
最新世代のLLMは、明確な指示と数件の例だけで十分な精度を出せる場合があります。まず小さく検証し、プロンプトだけでは解決しない課題が明確になってから追加の仕組みを選びましょう。
厳密には、RAGはモデル自体を再学習させる仕組みではありません。質問に関連する資料を検索し、回答時の参考情報としてLLMへ渡します。
学習データの内容を反映させることはできますが、情報が変わるたびに再学習が必要です。価格、在庫、規程など頻繁に更新される情報は、RAGやデータベース連携の方が管理しやすいでしょう。
なくなりません。関連資料を渡すことで抑えられる可能性はありますが、検索ミスや資料の読み違い、資料にない内容の生成は起こり得ます。出典表示、回答不能時のルール、評価と人による確認が必要です。
利用するモデルの規模や手法によります。クラウドサービスを利用する方法もあり、LoRAやQLoRAなら必要な計算資源を抑えられる場合があります。ただし、一般的な会社PCだけで大規模モデルを効率よく学習させるのは現実的ではありません。
一概には決められません。RAGには検索基盤の構築・保守と回答時の検索コストがあり、ファインチューニングにはデータ作成・学習・評価・再学習の費用があります。小規模な文書検索ではRAGから始めやすい一方、大量の定型処理ではファインチューニングが効率化につながる場合があります。
手元のPDFやメモを活用したいなら、まずRAGがおすすめです。文章の形式や分類を安定させたい場合も、最初はプロンプトと回答例を試し、改善しないときにファインチューニングを検討しましょう。
ファインチューニングとRAGは、目的の異なる技術です。
覚え方はシンプルです。
知識を渡すならRAG、答え方を身につけさせるならファインチューニング。
自分が解決したい問題を「知識」と「振る舞い」に分けると、どちらを選ぶべきか判断しやすくなります。
広告




コメント